
Matt Pocock Skills 使用指南
让 AI Agent 从代码生成器,升级为可靠的软件工程助手
Skills for Real Engineers. Straight from his
.claudedirectory.
这是一个面向 AI Coding Agent 的工程化工作流体系。 它不是提示词集合,而是将需求分析、领域建模、测试驱动、Bug 诊断、代码审查等软件工程实践封装成 Agent 可执行的 Skill。
目标:
让 AI 不只是“写代码”,而是按照优秀工程师的方法参与软件交付全过程。 Matt 的 Skills 本质上不是让 AI 更聪明,而是让 AI 像一个高级工程师一样思考,提升工程思维质量
目录
- 1. 概述与决策(先读这里)
- 2. 快速上手
- 3. Skill 全景图
- 4. 黄金工作流
- 5. 核心 Skill 教学
- 6. 动手练习
- 7. 团队落地指南
- 8. 常见问题与 FAQ
- 9. 设计哲学
- 10. 常见陷阱与避免方法
- 附录 A:参考资源
1. 概述与决策(先读这里)
阅读时间:5 分钟。 读完这一章,你就能判断这套 Skills 是否适合你的项目和团队。
1.1 理解 SKILL 这个概念
Matt Pocock(TypeScript 布道师,Total TypeScript 创始人)把他日常使用的 AI Agent Skills 开源了。
1.1.1 一句话定义
Skills 是一组小型、可组合、可改造的工程工作流模块——把"需求澄清、领域建模、测试驱动、问题诊断、架构审查"这些经典工程实践,重新包装成适合 AI Agent 调用的工作流指令。
1.1.2 SKILL 的物理形态
SKILL 是这套体系的原子单位——一个 Skill 就是一个独立的工程工作流指令包,通常是一个目录:
my-skill/
└── SKILL.md          # 主要指令(YAML 元数据 + Markdown 工作流)
├── template.md       # 可选模板
├── examples/         # 示例输出
└── scripts/          # 可执行脚本
SKILL.md 由两部分组成:
- YAML Frontmatter:定义
name(调用名)和description(触发条件描述)。Agent 加载到这个 Skill 时,先读 description——它决定何时触发。 - Markdown Body:实际的工作流指令。常见章节是 Philosophy / Anti-Patterns / Workflow / Reference Files。
1.1.3 与传统"提示词模板"相比的本质差异
| 维度 | 传统提示词 | Matt Pocock Skill |
|---|---|---|
| 形态 | 一段静态文字 | 标准化的目录结构 |
| 触发 | 用户手动调用 | Agent 根据 description 自动识别场景 |
| 组成 | 单一文本 | SKILL.md + 模板 + 示例 + 脚本 |
| 工程化 | 复制粘贴、版本无控 | Git 版本化、跨 Agent 复用 |
| 跨模型 | 绑死某个模型 | 纯 Markdown + YAML,Claude / GPT / Gemini 通吃 |
1.1.4 使用 Skills 的五大核心优势
- 可组合——10 多个 Skill 按需挑选,不强制"全家桶"
- 模型无关——纯文本格式,不被任何 AI 厂商锁定
- 渐进采用——可以一个一个地加,不必一次性全装
- 可改造——Matt 本人就鼓励"把它们变成你自己的"
- 跨会话持久化——
CONTEXT.md+ ADR 让工程纪律跨 Agent、跨会话保留
1.2 AI Coding 最大的问题:不是不会写,而是不可靠
AI 能快速生成代码——这毋庸置疑。但真实项目的真正挑战不是"AI 能不能写",而是"写出来的东西对不对、能不能长期维护"。
需求 → 生成代码 → 运行 → 发现问题 → 不断修补 → 代码越来越复杂

AI 写代码越来越快,但返工速度也越来越快。
AI Agent 在实际开发中反复出现四种失控模式:
- 不理解真实需求。AI 根据表面描述生成代码,却不知道业务边界——是否支持部分退款?是否需要审批?代码完成 ≠ 需求完成。 → 用
/grill-me或/grill-with-docs在动手前追问澄清。 - 缺少项目上下文。今天用
UserService,明天用AccountManager,同一个概念不同命名,代码风格持续漂移。 → 用CONTEXT.md建立共享领域语言。 - 遇到 Bug 靠猜测。改 A 不行改 B,改 B 不行改 C——把调试变成试错。 → 用
/diagnosing-bugs走六步科学诊断:复现 → 分析 → 验证 → 修复 → 回归。 - 长期迭代产生技术债。需求叠加,代码膨胀,架构边界模糊,维护成本指数上升。 → 用
/code-review持续审查 +/improve-codebase-architecture定期架构体检。
Skills 的核心目标不是替代工程师,而是给 AI 注入工程纪律——让 AI 从"高速代码生成器"变成遵循工程纪律的软件开发伙伴。
1.3 它不是什么
| ❌ 误解 | ✅ 实际 |
|---|---|
| 一个新的 AI Agent | 一组调用现有 Agent 的指令模板 |
| "全自动写代码"工具 | 让你保持控制权的纪律性辅助 |
| 一锤子买卖的大框架 | 小、可组合、按需安装 |
| 厂商锁定的 SDK | 标准 Markdown + YAML frontmatter,跨平台 |
"Approaches like GSD, BMAD, Spec-Kit try to own the process — but while doing so, they take away your control and make bugs hard to resolve. These skills are designed to be small, easy to adapt, and composable. They work with any model."
— Matt Pocock
1.4 适用性自评
在决定全量采用前,回答下面 5 个问题:
| # | 问题 | 是 → | 否 → |
|---|---|---|---|
| 1 | 你的项目预期寿命 ≥ 3 个月? | 适合 | 临时脚本不必引入 |
| 2 | 团队 ≥ 2 人? | 适合(CONTEXT.md 价值放大) | 单人项目可简化 |
| 3 | 你日常使用 AI Agent 写代码? | 建议采用 | 不用 AI 则不必 |
| 4 | 你的需求经常变更或不够明确? | 适合(grill-me 价值高) | 需求稳定的项目可选 |
| 5 | 你愿意维护 CONTEXT.md? | 适合 | 不愿维护文档则不建议 |
Skill 通用性分级:
| 评级 | Skills | 说明 |
|---|---|---|
| ⭐⭐⭐ 通用 | grill-me, grill-with-docs, tdd, diagnosing-bugs, to-prd (新命名 to-spec), code-review, domain-modeling | 任何语言、任何项目、任何团队直接受益 |
| ⭐⭐ 特定工作流 | to-issues (新命名 to-tickets), triage, improve-codebase-architecture, setup-matt-pocock-skills | 需要 Issue Tracker 或特定配置 |
| ⭐ 个人偏好 | migrate-to-shoehorn, scaffold-exercises, git-guardrails | 与 Matt 个人工具链绑定,可选 |
1.5 与 GSD / BMAD / Spec-Kit 的对比
| 对比维度 | GSD / BMAD / Spec-Kit | Matt Pocock Skills |
|---|---|---|
| 控制权 | 框架拥有流程 | 你保有控制权 |
| 粒度 | 大而全的单体框架 | 小、可组合、可独立替换 |
| 迁移成本 | 高(一次性全面切换) | 低(可渐进接入,逐个 Skill 采用) |
| 厂商锁定 | 有 | 无(标准 Markdown,跨平台) |
| 工程哲学 | 自动化优先 | 纪律优先 |
一句话总结:这套 Skills 代表 Agent 工程从"能力炫技"回到"交付纪律"。未来团队之间的差距,可能不只是"谁用了更强的模型",而是"谁更早把需求澄清、测试反馈、诊断纪律、架构治理真正接进了 Agent 的默认做事方式里"。
2. 快速上手
阅读时间:15 分钟。 这一章覆盖从零到跑通第一个工作流的全部步骤。
2.1 安装 Claude Code
Skills 是 Claude Code 的专属功能——存储在本地目录的 Markdown 文件,启动时由 Agent 自动扫描加载。网页版 Claude 无法加载本地 Skills 文件,所以必须先用 Claude Code。
# macOS / Linux / WSL(推荐)
curl -fsSL https://claude.ai/install.sh | bash

# 或 npm
npm install -g @anthropic-ai/claude-code

# 验证
claude --version
要求:macOS / Linux / Windows (WSL)、Node.js ≥ 18、Claude 订阅(Pro / Max / Team / Enterprise)。首次运行会引导浏览器认证。
2.2 使用路径图
flowchart LR
    A[📖 1. 概述与决策<br/>5 min] --> B[⚡ 2. 快速上手<br/>安装+初始化<br/>15 min]
    B --> C[🗺️ 3. Skill 全景图<br/>5 min]
    C --> D[🏆 4. 黄金工作流<br/>端到端<br/>10 min]
    D --> E[⭐ 5. 核心 Skill<br/>按需深入<br/>30 min]
    E --> F[🛠️ 6. 动手练习<br/>真实项目实操]
    F --> G[❓ 8. FAQ 答疑]
⭐ 标记的三个 Skill(
grill-me/tdd/diagnosing-bugs)是 Matt 本人最推荐的"第一波必装"。
2.3 安装 Skills
要求 Node.js ≥ 18(npx 依赖),GitHub CLI (gh) 可选(用于 Issue Tracker 集成)。
方案 1:全量安装(推荐首次使用)
# 在项目根目录执行
npx skills@latest add mattpocock/skills
# 非交互式终端
npx skills@latest add mattpocock/skills --yes
按交互提示选择 Skill、Agent(Claude Code)和安装范围(Project / Global)。务必勾选 /setup-matt-pocock-skills。
方案 2:按需安装(渐进采用)
npx skills@latest add mattpocock/skills --skill grill-me
npx skills@latest add mattpocock/skills --skill diagnose
npx skills@latest add mattpocock/skills --skill tdd
npx skills@latest add mattpocock/skills --skill to-prd     # 旧命名(仍可用)
npx skills@latest add mattpocock/skills --skill to-spec    # 新命名(推荐)
npx skills@latest add mattpocock/skills --skill to-issues  # 旧命名(仍可用)
npx skills@latest add mattpocock/skills --skill to-tickets # 新命名(推荐)核心原则:保留 ≤ 5 个核心 Skill,按需扩展。装太多反而让 AI 在决策时犹豫。
其他安装方式(脚注)
- 中文镜像:
git clone https://github.com/vinvcn/mattpocock-skills-zh-CN.git——保留原目录名/命令,仅翻译文档 - 全局安装:
npm install -g @mattpocock/skills——所有项目共享,但每个项目仍需单独跑 setup - 源码安装:克隆仓库后
pnpm install && pnpm link --global——用于开发自定义 Skill
安装位置
| Agent | 安装路径 |
|---|---|
| Claude Code | ~/.claude/skills/ 或项目 .claude/skills/ |
| Codex | .codex/skills/ |
| Cursor | .cursor/rules/ |
| OpenCode | .opencode/skills/ |
安装完成后重启 Agent,输入 /skills 验证。
2.4 项目初始化
安装完成后,每个项目需要运行一次初始化命令:
/setup-matt-pocock-skills初始化会依次询问三个问题:
| 问题 | 选项 | 说明 |
|---|---|---|
| Q1: Issue Tracker 选择 | GitHub Issues / Linear / Local Files | 推荐 GitHub Issues(需 gh CLI) |
| Q2: Triage 标签词汇表 | 自定义标签列表 | 例:needs-triage, needs-info, ready, wontfix |
| Q3: 文档存放路径 | 根目录 / docs/ 等 | CONTEXT.md 放项目根目录,ADR 放 docs/adr/ |
初始化完成后,项目中将生成以下文件:
your-project/
├── CONTEXT.md                 ← 领域语言词汇表(Agent 必读)
├── docs/
│   ├── adr/                   ← 架构决策记录
│   └── agents/
│       ├── domain.md          ← 领域语言定义
│       ├── triage-labels.md   ← Triage 标签定义
│       └── issue-tracker.md   ← Issue Tracker 配置
└── .claude/
    └── skills/                ← 已安装的 Skill 文件
CONTEXT.md 是项目的领域词典,记录所有专属术语的精确定义。Agent 每次执行任务前会先读取它,确保用语一致,建立"共享语言",从而解决 AI 啰嗦和幻觉问题。
CONTEXT.md 是懒加载的:第一个术语被澄清之前文件不存在,不需要预先搭架子,随着项目推进自然生长。
效果对比:
| Before(无 CONTEXT.md) | After(有 CONTEXT.md) |
|---|---|
| "a lesson inside a section of a course is made 'real'" | "materialization cascade" |
| 变量名不一致、函数名随意 | 基于共享语言的统一命名 |
| Agent 大量 Token 浪费在术语解释上 | 精确表达,Token 消耗大幅降低 |
示例 CONTEXT.md 片段(电商项目):
markdown## Domain Terms - **Order Lifecycle**: Draft → Placed → Paid → Fulfilled → Closed - **SKU**: Stock Keeping Unit. Inventory atom unit. 区别于 `Product`(营销聚合)。 - **Cart vs Basket**: 购物车未登录(Cart),已登录(Basket)。
2.5 验证安装
在 Coding Agent 中输入 /skills,你应该看到至少包含以下 Skill:
| 类别 | Skill |
|---|---|
| Engineering | grill-me, grill-with-docs, tdd, diagnosing-bugs |
| Productivity | teach, handoff |
| Misc | git-guardrails |
如果没看到 → 跳转到 §8.1 排查。
2.6 渐进式采用路径
Matt 本人建议分三个阶段引入 Skills,从"建立工程感"到"流程化"再到"成为 Skill 作者":
Week 1-2:掌握核心技能(建立工程感)
- 每天用
/grill-with-docs开始新功能(轻量场景可用/grill-me) - 用
/tdd实现至少两个功能 - 遇到 Bug 时跑
/diagnose(六步科学排查)
Week 3-4:建立项目基础设施(流程化)
- 为每个项目创建
CONTEXT.md - 开始记录 ADR 到
docs/adr/ - 用
/to-prd(新命名/to-spec) +/to-issues(新命名/to-tickets) 管理从对话到可执行任务
Month 2+:定制和创造(成为 Skill 作者)
- 用
/write-a-skill创建自己的技能 - 把反复使用的私人工作流封装成技能
- 为团队创建共享技能集
关键原则:好的工作流习惯越早建立越好。但不要一次性全装——挑当前最痛的痛点先解决,让肌肉记忆先成型,再扩展到下一个。
3. Skill 全景图
本节目录:3.1 仓库目录结构 · Skill 速查(场景 → 推荐) · 3.2 三大分类 · 3.3 Skill 依赖关系 · 3.4 按工作流触发点速查
阅读时间:5 分钟。 了解所有可用的 Skill 及其适用场景。
3.1 仓库目录结构
mattpocock/skills/
├── CLAUDE.md                 # Skill 注册与触发机制
├── CONTEXT.md                # 领域术语 + Issue Tracker 定义
├── README.md                 # 项目总览
├── docs/
│   ├── adr/                  # 架构决策记录模板
│   └── agents/               # Agent 配置参考
├── scripts/                  # skills.sh 安装脚本
├── skills/
│   ├── engineering/          # ★ 核心:代码开发类
│   │   ├── ask-matt/         # 路由器:帮你选 Skill
│   │   ├── code-review/      # 双轴代码审查
│   │   ├── codebase-design/  # 深模块设计准则
│   │   ├── design-an-interface/  # 多方案接口设计
│   │   ├── diagnosing-bugs/  # ★ 科学诊断六步法
│   │   ├── domain-modeling/  # 领域模型打磨
│   │   ├── grill-with-docs/  # ★ 追问 + 领域语言 + ADR
│   │   ├── implement/        # 基于 PRD 实现
│   │   ├── improve-codebase-architecture/  # ★ 架构腐化扫描
│   │   ├── prototype/        # 快速原型验证
│   │   ├── request-refactor-plan/  # 重构计划
│   │   ├── resolving-merge-conflicts/ # 合并冲突
│   │   ├── setup-matt-pocock-skills/ # ★ 一次性配置
│   │   ├── tdd/              # ★ TDD 红绿重构
│   │   ├── to-issues/        # PRD → Issue(新命名 to-tickets)
│   │   ├── to-prd/           # 对话 → PRD(新命名 to-spec)
│   │   ├── triage/           # Issue 状态机
│   │   ├── ubiquitous-language/ # 通用语言词汇表
│   │   └── wayfinder/        # 模糊问题导航
│   ├── productivity/         # 通用工作流
│   │   ├── grill-me/         # 纯追问
│   │   ├── grilling/         # 追问引擎
│   │   ├── handoff/          # 紧凑上下文摘要
│   │   ├── teach/            # 多会话教学
│   │   └── writing-great-skills/ # 元 Skill
│   ├── misc/                 # 辅助工具
│   │   ├── git-guardrails/   # 危险 git 操作拦截
│   │   ├── migrate-to-shoehorn/  # 类型断言迁移
│   │   ├── scaffold-exercises/   # 练习脚手架
│   │   └── setup-pre-commit/ # Husky + lint-staged
│   ├── personal/             # Matt 个人使用
│   ├── deprecated/           # 已废弃
│   └── in-progress/         # 开发中
Skill 速查(场景 → 推荐)
| 场景 | 推荐 Skill | 一句话说明 |
|---|---|---|
| 不知道该用哪个 Skill | ask-matt | 技能路由器,帮你选对入口 |
| 拿到一个模糊需求 | grill-me / grill-with-docs | 追问澄清、对齐共识 |
| 开始写代码前 | to-prd(新命名 to-spec)→ to-issues(新命名 to-tickets)→ tdd | 从需求到测试驱动实现 |
| 跑出 Bug | diagnosing-bugs | 科学诊断六步法 |
| 写完想审查 | code-review | 双轴代码审查 |
| 每隔几天做架构体检 | improve-codebase-architecture | 架构腐化扫描 |
| 多人交接 | handoff | 紧凑上下文摘要 |
3.1.1 SKILL.md 文件结构
每个 Skill 是一个独立目录,核心结构如下:
my-skill/
├── SKILL.md           # 主要指令(必需)
├── template.md        # 可选模板
├── examples/          # 示例输出
└── scripts/           # 可执行脚本
SKILL.md 由两部分组成:
YAML Frontmatter(决定 Skill 是否被触发):
name:调用名(如tdd)description:最关键,决定何时触发
Markdown Body(实际工作流指令):
- Philosophy(哲学):核心理念与原则
- Anti-Patterns(反模式):明确禁止的做法
- Workflow(流程):分阶段步骤(如 RED → GREEN → REFACTOR)
- Reference Files(参考文件):链接到同目录下的
tests.md/mocking.md等
描述写作的艺术:差描述("帮助写代码")太宽泛会误触发;好描述包含触发关键词——遵循"[功能]。当用户 [场景 A]、[场景 B] 或 [场景 C] 时使用"的模式。
参考文件拆分原则:
SKILL.md超过 100 行时考虑拆分;涉及明显不同领域(如财务 vs 销售)时分开;高级功能不常使用时单独存放。
3.2 三大分类
| 类别 | 路径 | 定位 | 代表 Skill |
|---|---|---|---|
| Engineering | skills/engineering/ | 代码开发全生命周期 | tdd, code-review, diagnosing-bugs, to-prd (新命名 to-spec) |
| Productivity | skills/productivity/ | 通用工作流与协作 | grill-me, handoff, teach |
| Misc | skills/misc/ | 辅助工具与自动化 | git-guardrails, setup-pre-commit |
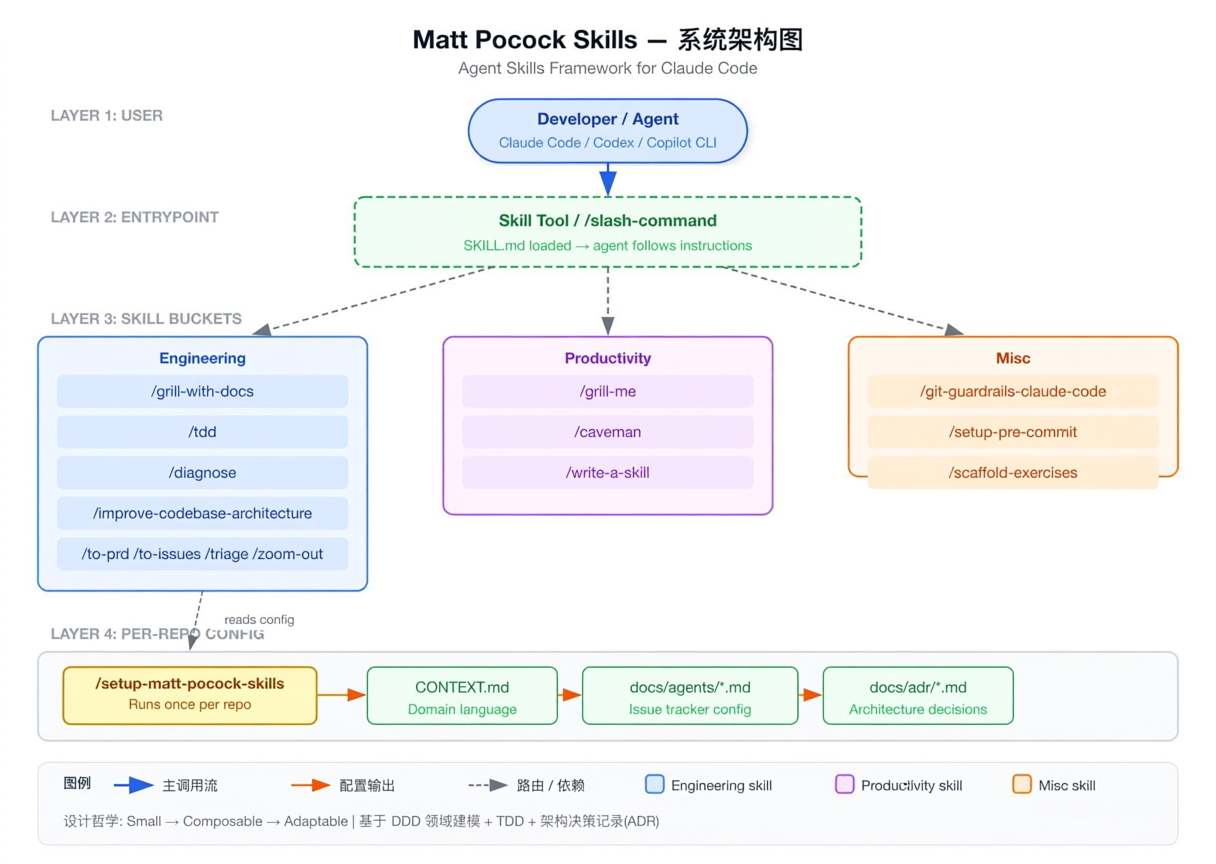
3.3 Skill 依赖关系
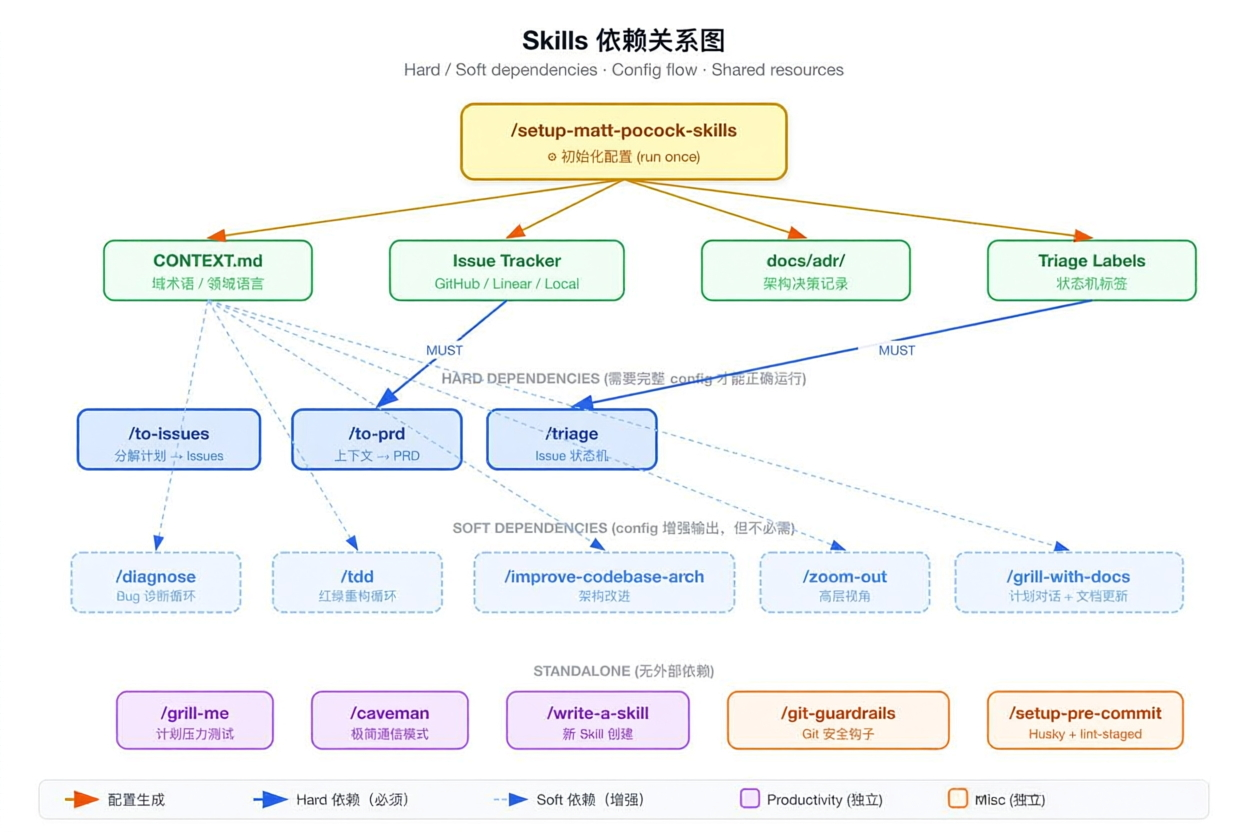
3.4 按工作流触发点速查
| 触发点 | Skill | 触发方式 |
|---|---|---|
| 不知道该用哪个 Skill | ask-matt | 用户 / 模型 |
| 拿到一个模糊需求 | grill-me / grill-with-docs | 用户 |
| 需求对齐后想写文档 | to-prd(新命名 to-spec) | 用户 |
| PRD 出来后想拆任务 | to-issues(新命名 to-tickets) | 用户 |
| 开始写代码 | tdd | 模型(Agent 主动) |
| 写完后想审查 | code-review | 模型 |
| 跑出 Bug | diagnosing-bugs | 模型 |
| 每隔几天想做架构体检 | improve-codebase-architecture | 用户 |
| 多人交接 | handoff | 用户 |
| 想学新概念 | teach | 用户 |
4. 黄金工作流
阅读时间:10 分钟。 理解从需求到上线的完整链路。
4.1 端到端链路
flowchart TD
    A[💬 拿到一个新需求] --> B["/grill-me<br/>或 /grill-with-docs"]
    B --> C{需求清晰?}
    C -->|否| B
    C -->|是| D[""/to-prd (新命名 /to-spec)"]
    D --> E[PRD 完成]
    E --> F[""/to-issues (新命名 /to-tickets)"]
    F --> G[Issue 列表]
    G --> H{选一个 Issue}
    H --> I["/tdd"]
    I --> J[代码完成]
    J --> K["/code-review"]
    K --> L{审查通过?}
    L -->|否| I
    L -->|是| M[合入主干]
    M --> H
    H -->|都做完了| N[🎉 功能上线]
4.2 日常节奏
| 频率 | 动作 | Skill |
|---|---|---|
| 每次新需求 | 需求澄清 → PRD → Issue | /grill-with-docs → /to-prd (新命名 /to-spec) → /to-issues (新命名 /to-tickets) |
| 每个 Issue | 红绿重构 | /tdd |
| 遇到 Bug | 六步科学诊断 | /diagnosing-bugs |
| 每几天 | 架构健康检查 | /improve-codebase-architecture |
| 完成功能 | 双轴审查 | /code-review |
| 跨人 / 跨会话交接 | 紧凑上下文摘要 | /handoff |
5. 核心 Skill 教学
本节目录:5.0 ask-matt · 5.1 grill-with-docs · 5.2 tdd · 5.3 diagnosing-bugs · 5.4 improve-codebase-architecture · 5.5 code-review · 5.6 to-prd → to-issues
按需阅读。 每个 Skill 独立成章,你可以根据当前痛点跳读。
5.0 ask-matt — 技能导航器
面对 50 个 Skill,新手很难知道从哪个开始。ask-matt 是一个路由器:你描述当前的情况和想做的事,它推荐最适合的 Skill 或流程。本质上是一个 Skill 体系的交互式索引。
触发词:
/ask-matt,"Which skill should I use for..."
5.1 grill-with-docs — 共识对齐引擎 ⭐
这是 Matt 最核心的 Skill。它不只是一个需求追问工具,而是一个共识对齐引擎,解决"需求跑偏"问题,强制在动手之前先对齐认知。
执行时序:
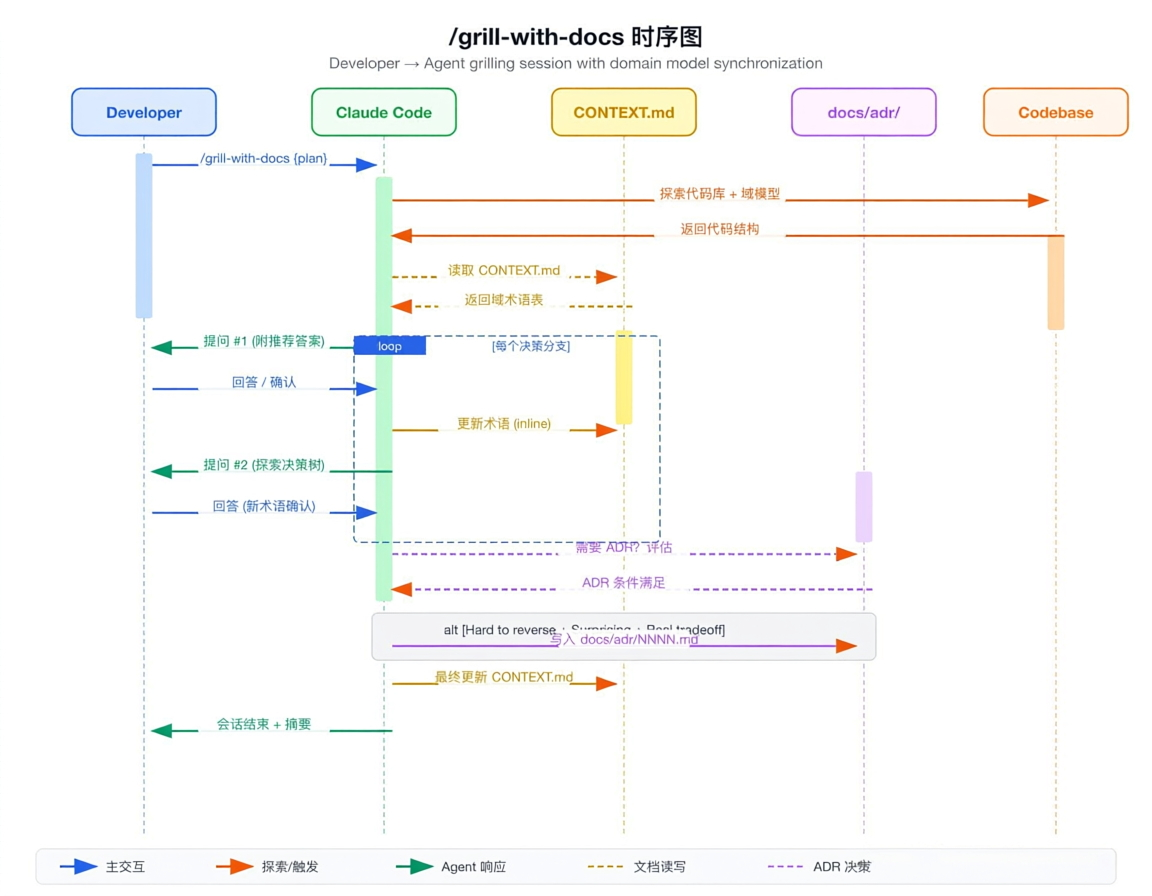
产出物:
- 更新
CONTEXT.md(领域语言词汇表) - 创建
docs/adr/NNNN-xxx.md(架构决策记录)
对话风格:
- 一次只问一个问题
- 每个问题附带基于代码库的推荐答案
- 涉及难逆转的变更时,强制写 ADR
演进历史(理解这个 Skill 为何这样设计):
grill-me(通用追问)
  → ubiquitous-language(DDD 词汇表)
    → domain-model(追问 + 领域建模 + 限界上下文)
      → grill-with-docs(domain-model + ADR + 内联文档更新)
Matt 发现单独使用 grill-me 时常需同时跑 ubiquitous-language 维护术语表,效率太低,于是逐步合并成 grill-with-docs——一个 Skill 同时承担"追问 + 领域语言 + ADR + 内联文档更新"四件事。这个演进过程解释了为什么它"看起来功能多"——其实每个能力背后都有它要解决的明确痛点。
示例对话:
Q: "新建订单后,要不要立即扣减库存?"
   ├─ A: 立即扣减(推荐)— 防止超卖,但需要分布式事务
   ├─ B: 延迟扣减(下单后定时任务)— 简单但可能超卖
   └─ C: 预占库存(不实际扣减,标记 reserved)— 折中方案

基于你的代码库:看到 OrderService.create() 没有事务边界,
推荐 A + Seata Saga 或 C。
5.2 tdd — 红绿重构循环 ⭐
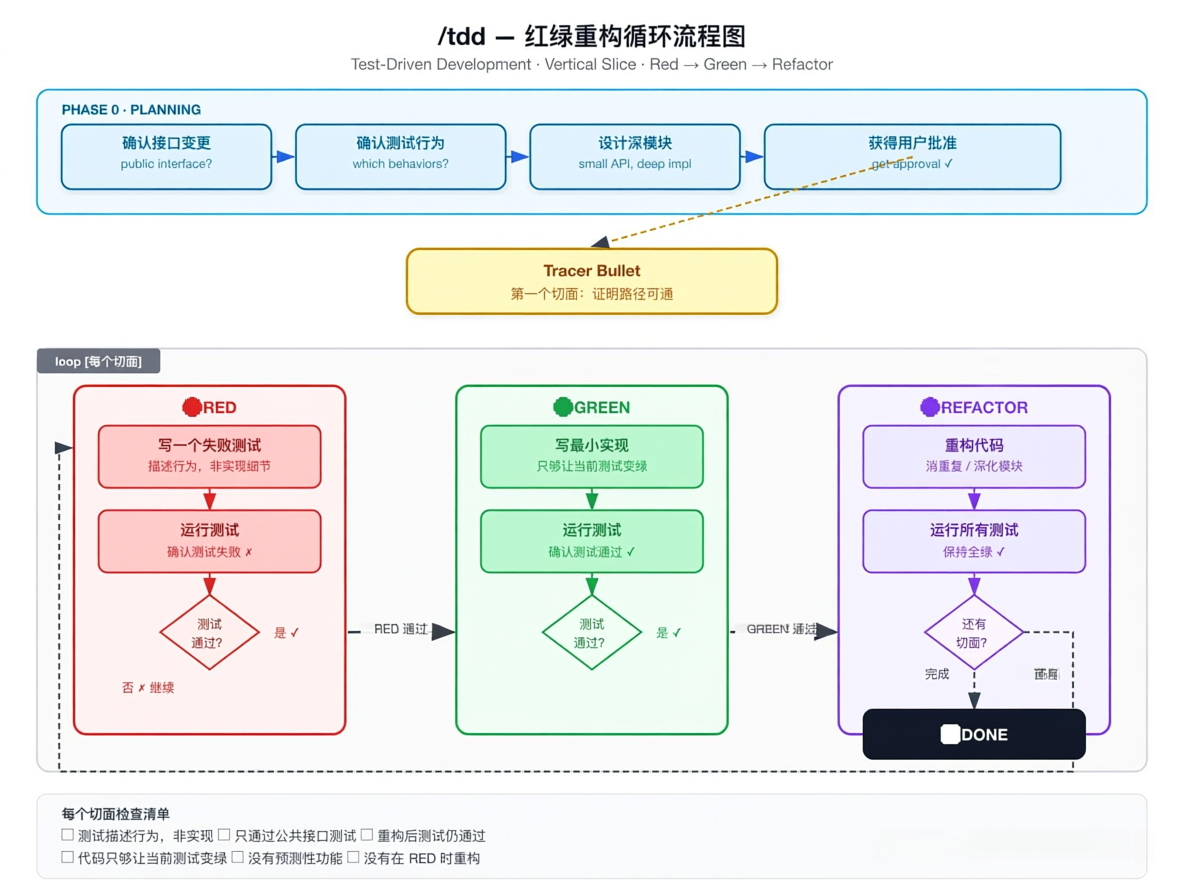
TDD 提供快速反馈闭环,让代码真正可靠。
核心原则:
- 一次只做一件事(一个测试 → 一个实现)
- 测试读起来像规格说明,能扛住重构
- 行为测试而非实现测试
五条铁律:
- 垂直切片,不一次性写完所有测试:一次一个行为,每个循环都被上一个循环教会了什么。
- 第一个循环是"曳光弹"(Tracer Bullet):一条从端到端全部打通的路径,证明整个链路活着,然后从这条路径向外扩展。
- 测试只针对公开接口:确保重命名内部函数永远不会破坏测试。
- 预期值必须来自独立的真相来源:比如规格书里的固定数字、手工计算的结果。绝不能用和代码相同的逻辑再算一遍——那叫"同义反复测试",一定通过但什么都验证不了。
- 红色期间不动结构,重构只在全部变绿后进行:红 → 最小实现(绿)→ 重构,顺序不可颠倒。
典型工作流:
// RED: 写一个失败的测试
test('applyDiscount(100, "VIP") should return 80', () => {
  expect(applyDiscount(100, 'VIP')).toBe(80);
});

// GREEN: 最小实现
function applyDiscount(price: number, level: string): number {
  return level === 'VIP' ? price * 0.8 : price;
}

// REFACTOR: 抽出策略表
const DISCOUNTS = { VIP: 0.8, GOLD: 0.9 } as const;
function applyDiscount(price: number, level: keyof typeof DISCOUNTS): number {
  return price * (DISCOUNTS[level] ?? 1);
}
TDD 的取舍:业务核心代码(订单、支付)严格 TDD;胶水代码(配置、DTO 转换)可以跳过;UI 组件可以用快照测试代替。TDD 的目的是快速反馈,不是为了 TDD 而 TDD。
行为测试的判断标准(Kent Beck 原则的实操化):
"如果你重构了内部实现但行为没变,测试不应该失败。如果失败了,说明测试的是实现而非行为。"
实操三问:
- 测试通过公共 API 验证真实代码路径吗?
- 重命名内部协作者,测试还能通过吗?
- 如果直接绕过接口查数据库 / 调用私有方法,测试还能通过吗?
如果第二、三问的答案是"否",说明测试在锁实现细节——重构时它会反过来咬你。
5.3 diagnosing-bugs — 科学诊断六步法 ⭐
Reproduce       → 复现 Bug
                · 复现的是同一个 bug 还是只是相似症状?
Minimise        → 最小化复现用例
                · 运行一次需要多久?能否缩短到 2 秒内?
Hypothesise     → 提出 3-5 个假设(先发散,再聚焦)
                · 是否陷入了第一个想法的锚定效应?
Instrument      → 插桩验证
                · 每个日志是否带唯一前缀(如 [DEBUG-a4f2])方便后续清理?
Fix             → 修复
Regression-test → 回归测试,防止复发
· 测试是否在修复前失败、修复后通过?每个阶段的关键问题:
| 阶段 | 目标 | 必须回答的灵魂拷问 |
|---|---|---|
| 构建反馈循环 | 确保能快速验证 bug 是否存在 | "运行一次需要多久?能否缩短到 2 秒内?" |
| 复现 | 确认能稳定复现问题 | "复现的是同一个 bug 还是只是相似症状?" |
| 假设 | 在测试前先生成 3-5 个可证伪的假设 | "是否陷入了第一个想法的锚定效应?" |
| 仪器化 | 添加日志或断点来区分假设 | "每个日志是否带唯一前缀便于清理?" |
| 修复与回归测试 | 先写回归测试,再修复 | "测试是否在修复前失败、修复后通过?" |
| 清理与复盘 | 移除仪器化代码,记录教训 | "是否从这次经历中学到了可分享的教训?" |
这个流程的价值不仅在于它有效,更在于它防止你陷入常见的调试陷阱。例如,"假设"阶段要求你在测试前先生成多个假设,这直接对抗了认知锚定——人类倾向于坚持第一个想到的解释,即使它是错的。
状态机视角:
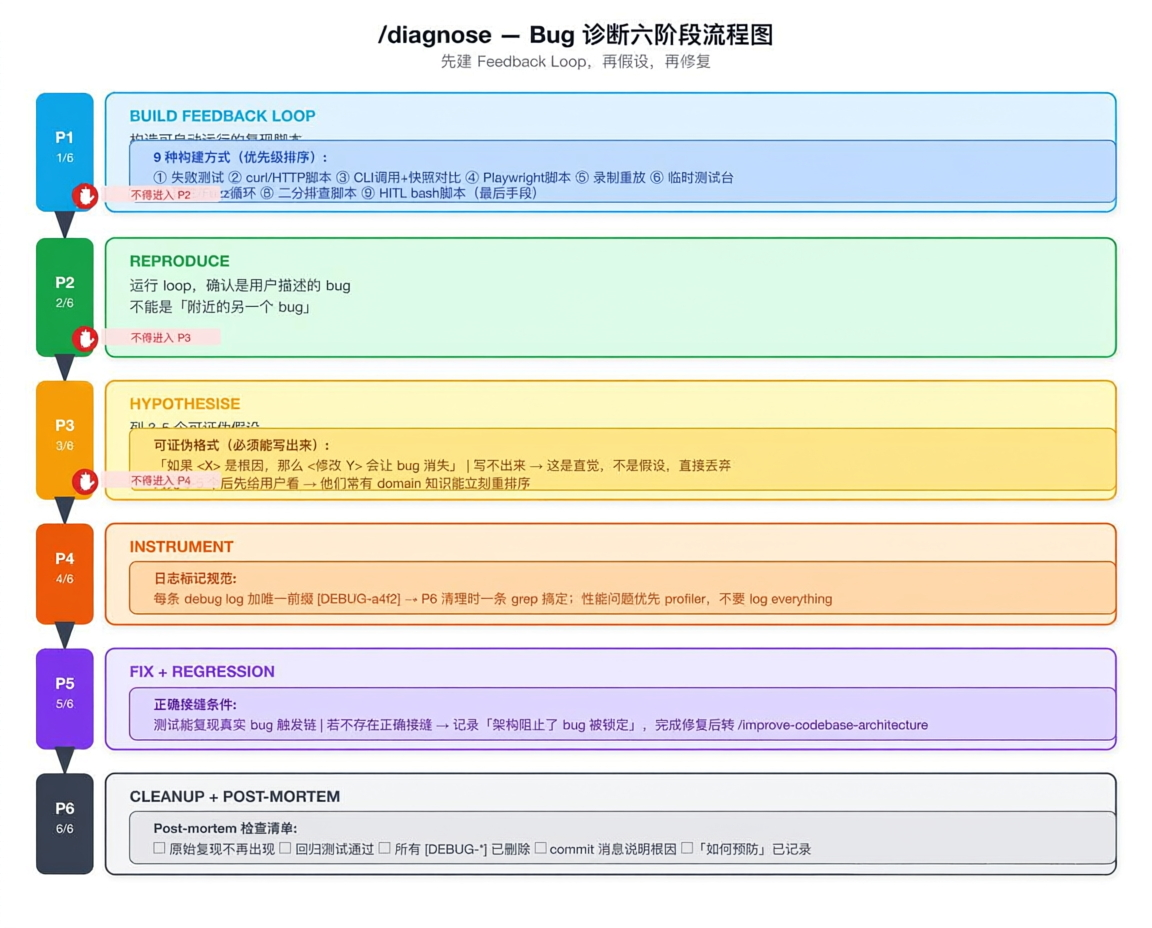
反面教材:直接
git diff改代码、瞎试 Stack Overflow 的答案。这正是这个 Skill 想要杜绝的"直觉排查"。
5.4 improve-codebase-architecture — 架构健康检查
扫描代码库的"深模块化"机会,对抗架构腐化,治理技术债:
- 识别模块边界腐化
- 发现重复逻辑和冗余抽象
- 生成可视化 HTML 报告
- 挑选一个优先项进行 Grilling 深入
工作流:
代码库 → 扫描器 → HTML 报告(含可视化)→ 选择优先项 → grill-with-docs 深入分析 → 产出架构改进任务5.5 code-review — 双轴审查
两个并行子代理同时运行,互不污染:
为什么要并行? 防止两边的上下文互相污染。一段代码可以完全符合规范却实现了错的东西(标准过、规格挂),也可以完美兑现需求却违反项目约定(规格过、标准挂)。两条线分开汇报,不合并,不交叉打分。
| 轴 | 审查内容 | 关注点 |
|---|---|---|
| Standards | 是否遵循编码规范?是否存在坏味道? | 命名、函数长度、重复代码、抽象泄漏 |
| Spec | 是否忠实实现 Issue/PRD 要求? | 验收标准、边界条件、缺失需求 |
flowchart TB
    PR[Pull Request] --> S1[Standards<br/>子代理]
    PR --> S2[Spec<br/>子代理]
    S1 --> R1[报告 A:编码规范问题]
    S2 --> R2[报告 B:需求实现偏差]
    R1 --> M[人工 Reviewer<br/>综合两份报告]
    R2 --> M
    M --> Decision{通过?}
    Decision -->|是| Merge[合并]
    Decision -->|否| Fix[打回修改]
5.6 to-prd → to-issues(新命名:to-spec → to-tickets)— 从想法到可执行任务
对话上下文(模糊需求)
  → /to-prd (新命名 /to-spec)
    → PRD(User Story + 验收标准 + 涉及模块)
      → /to-issues (新命名 /to-tickets)
        ├── Issue 1(独立可交付)──┐
        ├── Issue 2(独立可交付)──┤→ /tdd 逐个实现
└── Issue 3(独立可交付)──┘关键:每个 Issue 必须是垂直切片(端到端可交付),而不是水平分层("建表 → 写 API → 写 UI")。
注意:PRD 没有写清楚之前不要开始
/tdd——流程应该是/to-prd(新命名/to-spec) →/to-issues(新命名/to-tickets) →/tdd,否则等于"测空气"。
6. 动手练习
本节目录:6.1 练习 1:5 分钟跑通 grill-me · 6.2 练习 2:15 分钟跑通 tdd · 6.3 练习 3:30 分钟跑通完整黄金链路 · 6.4 练习 4:诊断一个真实 Bug
在真实项目里跑一遍,别用示例项目。
6.1 练习 1:5 分钟跑通 grill-me
- 在 Coding Agent 里输入
/grill-me - 描述一个真实的小需求(例如"加个导出 CSV 按钮")
- 让 Agent 至少追问 5 个问题
- 全部回答后,回看对话:Agent 抓住了几个你没想清楚的点?
验收标准:你至少发现了 1 个自己没考虑到的边界条件。
6.2 练习 2:15 分钟跑通 tdd
- 选一个 Issue(或者练习 1 产出的最小切片)
- 输入
/tdd - 严格按 RED → GREEN → REFACTOR 走
- 每个阶段提交一次 git commit
验收标准:你的 commit 历史长这样:
test: add failing test for applyDiscount
feat: implement applyDiscount with hardcoded VIP case
refactor: extract DISCOUNTS table
6.3 练习 3:30 分钟跑通完整黄金链路
- 选一个真实的需求(不是练习用的)
- 依次跑:
/grill-with-docs→/to-prd(新命名/to-spec) →/to-issues(新命名/to-tickets) →/tdd(对每个 Issue) - 提交一份 PR,里面包含:
CONTEXT.md的 diff(如果新增了术语)docs/adr/00XX-xxx.md(如果涉及架构决策)- 1 个或多个 commit,每个 commit 都能独立编译
验收标准:同事看了 PR,能在不读代码的情况下,从 ADR 理解"为什么这么改"。
6.4 练习 4:诊断一个真实 Bug
- 找一个你项目里最近修过的 Bug
- 假装"穿越回去"重新修:用
/diagnosing-bugs的六步法 - 对比你的修复路径和 Agent 推荐的路径,差异在哪?
验收标准:你至少发现 1 个自己当时没走过的诊断步骤(比如没最小化复现用例、没写回归测试)。
7. 团队落地指南
7.1 角色分工
| 角色 | 职责 | 推荐起步 Skill |
|---|---|---|
| Champion(1 人) | 先跑通全流程,产出团队模板和 FAQ | grill-me, grill-with-docs, tdd |
| 早期采用者(2-3 人) | 在真实项目中试用,反馈痛点 | grill-me, tdd, diagnosing-bugs |
| 全团队 | Champion 验证可行后统一推广 | grill-me, tdd |
7.2 现有工具适配
| 团队现状 | 适配建议 |
|---|---|
| 使用 GitHub Issues | 完整支持,直接使用 /to-issues (新命名 /to-tickets) 和 /triage |
| 使用 GitLab Issues | /to-issues (新命名 /to-tickets) 和 /triage 需手动创建 Issue;其他 Skill 不受影响 |
| 使用 Jira | 同上,可考虑开发 Jira 适配的 /to-issues (新命名 /to-tickets) 变体 |
| 使用 Linear | 原生支持 |
| 无 Issue Tracker | 使用 Local Files 模式(.scratch/ 下的 Markdown) |
7.3 采用策略
- 第 1-2 周:Champion 独自跑通完整链路,产出团队的 CONTEXT.md 模板和一份 "Lessons Learned" 文档
- 第 3-4 周:2-3 名早期采用者加入,在日常开发中使用 grill-me 和 tdd
- 第 5-8 周:Champion 根据反馈调整团队规范,准备推广材料
- 第 9 周起:全团队采用,将
/grill-with-docs和/tdd写入团队开发规范
关键:不要一次性全团队切换。让少数人先验证价值,用实际案例说服其他人。
8. 常见问题与 FAQ
本节目录:8.1 /skills 命令看不到任何东西 · 8.2 Agent 装上 Skill 后还是按自己方式写代码 · 8.3 CONTEXT.md 越来越臃肿怎么办? · 8.4 Skills 装太多会怎样? · 8.5 自定义 Agent 无法加载 Skill? · 8.6 Cursor 中如何配置?
8.1 /skills 命令看不到任何东西
请按以下决策树依次排查:
/skills 无响应
├─ 1. Agent 重启了吗?
│   ├─ 否 → 重启 Agent,然后回到步骤 2
│   └─ 是 → 进入步骤 2
├─ 2. Skills 装到哪了?
│   ├─ 全局安装 → 检查 ~/.claude/skills/ 目录是否存在
│   └─ 项目安装 → 检查 .claude/skills/ 目录是否存在
├─ 3. 目录存在吗?
│   ├─ 否 → 重新执行 npx skills@latest add mattpocock/skills
│   └─ 是 → 进入步骤 4
└─ 4. SKILL.md 格式正确吗?
    ├─ 否 → 修复 YAML frontmatter(确保 --- 配对、缩进正确)
    └─ 是 → 查看 Agent 日志排查更深层问题
8.2 Agent 装上 Skill 后还是按自己方式写代码
原因:Skills 是指令而不是枷锁。Agent 有时仍会"忘记"使用。
对策:
- 在
CLAUDE.md(项目根目录)里显式声明要使用哪些 Skill - 在
CONTEXT.md里加一段## Workflow Preferences,写明"每次新功能必须先 /grill-me"
8.3 CONTEXT.md 越来越臃肿怎么办?
原则:
- 只保留领域专属术语(项目里独有的、Agent 猜不到的)
- 通用编程概念不要写(如 "REST"、"依赖注入")
- 超过 200 行就拆:
CONTEXT.orders.md、CONTEXT.billing.md - 拆分后在主
CONTEXT.md中添加索引引用(如- [订单领域](./CONTEXT.orders.md)),Agent 可通过索引发现子文件
8.4 Skills 装太多会怎样?
症状:
- Agent 在
/grill-me时犹豫不决,问太多无关问题 - TDD 流程被某个不相干的 Skill 中断
- Token 消耗增加
对策:保留 ≤ 5 个核心 Skill,其他按需加载。
8.5 自定义 Agent 无法加载 Skill?
检查要点:
SKILL.md格式是否正确(标准 Markdown,YAML frontmatter)- 目录结构是否规范(每个 Skill 独占文件夹)
- Agent 是否重启(安装后必须重启)
8.6 Cursor 中如何配置?
- Settings → Rules → 创建自定义 Rule
- 粘贴对应
SKILL.md内容 - 设置为
always或agent-requested触发模式
9. 设计哲学
哲学部分分两层:先讲动机(为什么要这么做),再讲原则(具体怎么做)。读到这里如果只挑一节读,先读 §9.1。
9.1 四大核心哲学(动机层)
在六大底层原则之上,Matt 提炼了四个更底层的动机——它们决定了"为什么"要遵守这些原则:
- 对齐优先于速度。大多数 AI 编程的问题不是写得慢,而是"没造对人想要的东西"。
grill-me和grill-with-docs的存在就是为了让对齐发生在动手之前。 - 理解胜于记忆。不要死记语法,而要理解类型系统、设计权衡、依赖关系如何思考。当底层逻辑清晰,重构和迁移才不慌。
- 垂直切片优于水平分层。传统开发先写所有表、再写所有 API、最后写 UI;
tdd和to-issues(新命名to-tickets)推崇端到端薄切片,每个功能从 DB 到 UI 完整跑通一小条,确保任何时刻系统都是可交付的。 - 显式优于隐式。每个重要决策都应该被记录——
CONTEXT.md记领域语言,docs/adr/记架构决策。这不仅帮 AI 理解,也帮未来的你自己。
这四条原则是其他所有工具性原则的"为什么"。当你犹豫要不要多走一步对齐流程、或该不该写 ADR 时,回头看这一节。
9.2 六大底层原则(技术层)
- 垂直切片:端到端薄切片,贯穿 grill → prd → issues → tdd 全链路
- 深模块(John Ousterhout):小接口大实现,贯穿 codebase-design
- Design It Twice:不满足于第一个方案,用 /prototype 并行探索
- 极小提交:每步可运行,每步可回退
- 行为测试:测试读起来像规格说明,而非实现细节
- 无状态 + 文件:CONTEXT.md 和 ADR 作为持久化载体,跨 Agent 和跨会话流转
9.3 项目适配说明(bpp 仓库)
本仓库在很大程度上已采纳 Matt Pocock 体系,但用 Trellis + GitNexus 对若干职责做了重新命名/重新实现。新人对照时容易混淆,这里给一份速览:
| Matt Pocock 原版 | 本仓库对应物 | 状态 |
|---|---|---|
CONTEXT.md 放项目根 | 项目根已有 CONTEXT.md | 🟢 已对齐 |
docs/adr/ | 本仓库 ADR 目录统一在 docs/adr/(doc/ 仅保留遗留部署说明 / DDL / 开发方案) | 🟢 已对齐 |
GitHub Issues + gh CLI | GitLab + glab CLI(docs/agents/issue-tracker.md) | 🟡 生态分歧(已显式适配) |
/to-prd (新命名 /to-spec) → /to-issues (新命名 /to-tickets) | Trellis .trellis/tasks/<task>/prd.md + task.json | 🟡 替代方案 |
/handoff 跨会话摘要 | Trellis JSONL 注入 + task.py current | 🟡 替代方案 |
git-guardrails | Trellis Phase 3.4 强制派发协议 | 🟡 替代方案 |
/tdd 红绿重构 | 未配置(PHP + 既有 CI 体系) | 🟠 未适配 |
/diagnosing-bugs 六步法 | bpp-troubleshoot skill(未声明映射关系) | 🟠 未映射 |
/code-review 双轴 | superpowers:code-reviewer + simplify(未声明双轴关系) | 🟠 未映射 |
最关键一点:本仓库不是"没采纳 Matt Pocock 体系",而是**"用 Trellis + GitNexus 用不同名字重新实现了同构问题"**。两个体系并存,遇到术语冲突时以本仓库的 docs/agents/*.md 为准。
此节由
/grill-with-docssession 于 2026-07-22 沉淀(参考 task:.trellis/tasks/07-09-fancl-invoice-api)。
10. 常见陷阱与避免方法
使用 Matt Pocock Skills 过程中的高频踩坑点(高频踩坑以表格形式汇总在下方 10.1):
10.1 核心警示
| # | 陷阱 | 表现 | 解决方案 |
|---|---|---|---|
| 1 | 技能过载 | 装太多 Skill,Claude 频繁误触发、决策犹豫 | 只装当前最痛的;定期清理,保留 ≤ 5 个核心 |
| 2 | 忽略对齐 | 跳过 grill-me 直接让 AI 写代码 | 坚持"先对齐再动手"——5 分钟对齐节省 5 小时返工 |
| 3 | TDD 循环过大 | 一个 RED-GREEN-REFACTOR 循环超过 30 分钟 | 进一步切片,控制单个循环在 5-10 分钟内 |
| 4 | CONTEXT.md 过时 | 项目语言已演变但词汇表未更新 | 每次 grill-with-docs 后检查更新 |
| 5 | 忘记提交 | 做了很多修改但没有版本控制 | 把 tdd 技能的提交步骤变成肌肉记忆 |
| 6 | 过度依赖 AI | 不理解 AI 写的代码就接受 | 要求 AI 解释每段代码,不懂就问——AI 是搭档不是替身 |
核心警示:Skills 给你纪律,不是给你捷径。最大的陷阱是把"用了 Skill"等同于"做了工程"——Skill 只是工具,工程思维在你脑子里。
附录 A:参考资源
延伸阅读
- John Ousterhout《A Philosophy of Software Design》—— 深模块思想的源头
- Kent Beck《Extreme Programming Explained》—— TDD 起源
- Eric Evans《Domain-Driven Design》—— Ubiquitous Language 概念
- David Thomas & Andrew Hunt《The Pragmatic Programmer》—— Grilling 引用来源
版权说明
本文档内容基于 Matt Pocock Skills(MIT License)编写,属于对该项目的使用指南和中文解读。原始 Skills 代码和设计归 Matt Pocock 所有。
图表说明:本文档中的 Mermaid 图表在 GitHub / GitLab Markdown、VS Code(需 Mermaid 插件)、Obsidian、Typora 中可直接渲染。如果在不支持的平台查看,可复制图表源码到 mermaid.live 预览。